
 1 час назад
2
Приветствую, любители нагрузки. Сразу переходим к делу - прошлым выпускам:
Прошлые выпускиPerfscale news #5. SQL, Thresholds, неработающие Linked Accounts
Perfscale news #8. WS Benchmark, Jmeter open sourced & fixed linked accounts
Perfscale news #10. Shared variables, Pub/Sub load testing & live metrics
Perscale news #11. Fine‑grained token, SQID, stdout log streaming
Perfscale news #12. WASM‑библиотеки, SDK для авторов и «живые» логи
Perfscale news #13. Выжигание WASM модулей, http3 и первый postmortem
Perfscale news #14. Фикс fix, api reference и поддержка webrtc
Сегодня у нас в выпуске все изменения относятся OSS, поскольку у нас просто закончились Github actions по минутам (сейчас там ~90% использования). Этот релиз примечателен тем, что почти все изменения относятся к метрикам.
Perfscale OSS
Главная цифра релиза — запись метрик. Метрики переведены на шардированную структуру ShardedMetrics (ранее был Arc<Mutex<Metrics>> а стало Vec<Mutex<Metrics>>), и пропускная способность выросла с 14.7M до 118.6M ops/s на 16 потоках. Поскольку все потоки становятся утилизированными и это и дает большую пропускную способность. Не забывайте, что вы можете уперется в количество ulimit и ограничение по сокетам в вашей ОС. Экспериментируйте.
perfscale serve
Мы также переделываем понемногу serve команду и сам сервер, добавив несколько возможностей. Начнем с документации. Теперь при запуске serve и открытии страницы в браузере
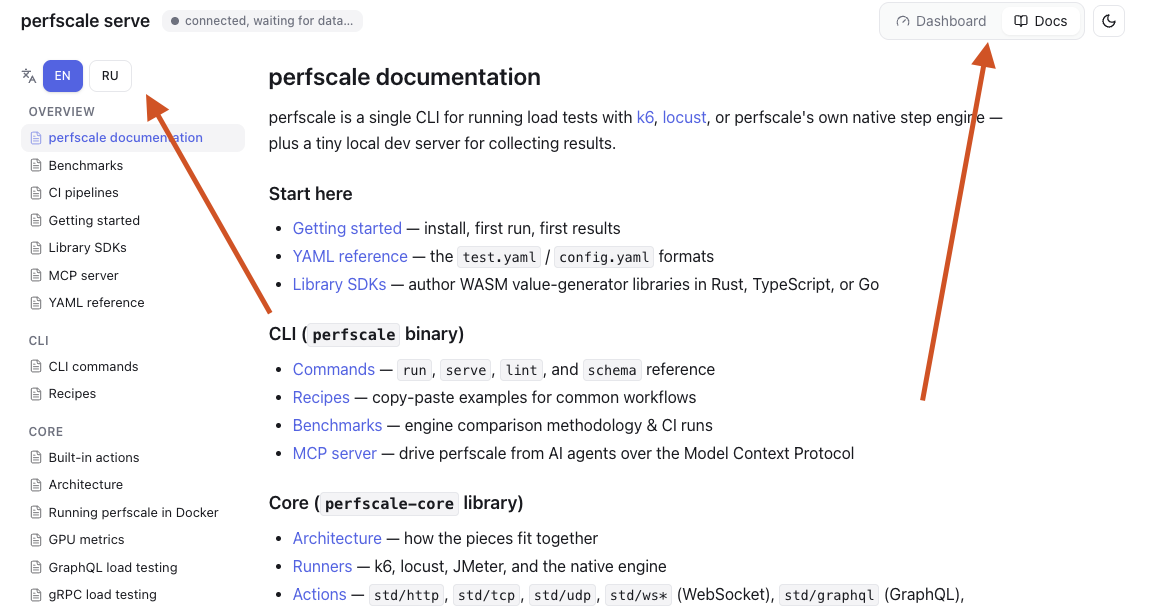
Вся документация переведена на 2 языка, как и в perfscale.[su/ru]/docs/oss.
Обновленный bench профиль
1 раз в день у нас запускается bench профиль, где мы гоняли на сервере сравнение perfscale с locust, k6 и jmeter на предмет разных утечек в различных сценариях. Поскольку у нас появилось тестирование SQL (об этом была новость #5 ) но заметили, что в bench профиле нет замеров с K6. Также мы замеряем не с голым k6, а собранным xk6 + sql. Результаты можете посмотреть ниже на скриншоте.
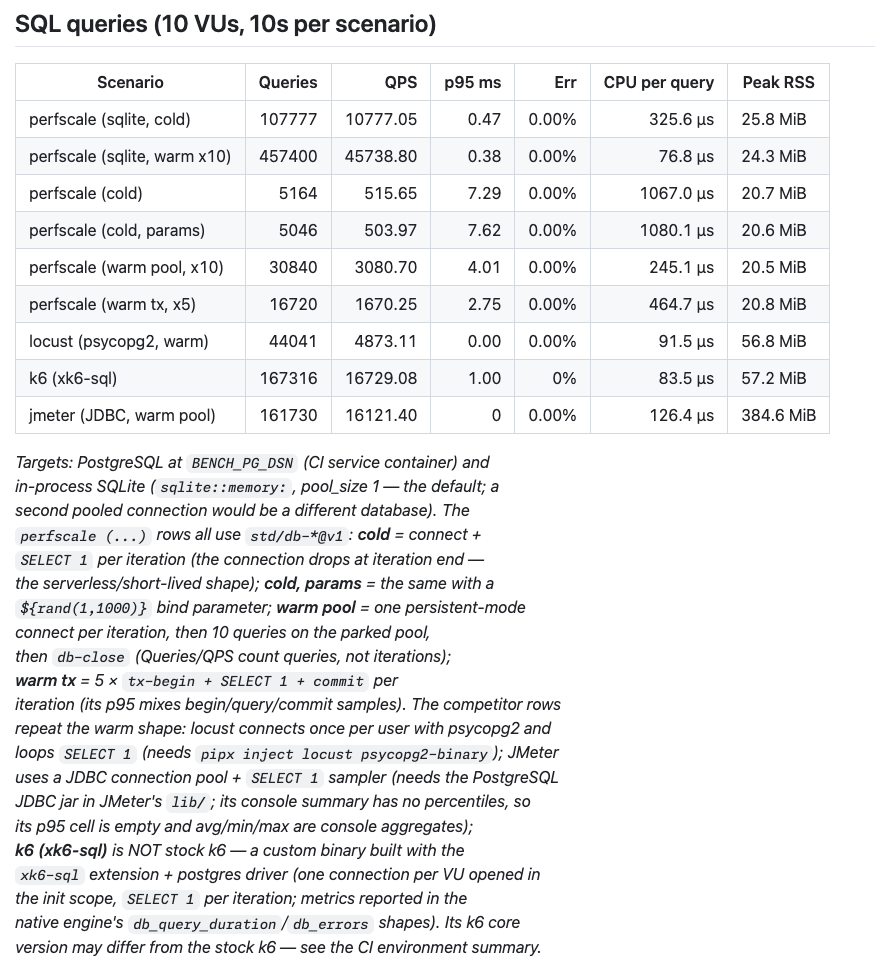
Перевод:
Цели: PostgreSQL по BENCH_PG_DSN (сервисный контейнер CI) и встроенный SQLite (sqlite::memory:, pool_size 1 — по умолчанию; второе подключение из пула было бы другой базой данных). Строки perfscale (...) все используют std/db-*@v1: cold = подключение + SELECT 1 на итерацию (подключение разрывается в конце итерации — бессерверная/краткоживущая форма); cold, params = то же самое с параметром привязки ${rand(1,1000)}; warm pool = одно подключение в постоянном режиме на итерацию, затем 10 запросов к припаркованному пулу, затем db-close (Queries/QPS считают запросы, а не итерации); warm tx = 5 × tx-begin + SELECT 1 + commit на итерацию (его p95 смешивает образцы begin/query/commit). Строки конкурентов повторяют форму warm: locust подключается один раз на пользователя с psycopg2 и выполняет SELECT 1 в цикле (нужен pipx inject locust psycopg2-binary); JMeter использует пул JDBC-подключений + сэмплер SELECT 1 (нужен PostgreSQL JDBC jar в lib/ JMeter; в его консольной сводке нет перцентилей, поэтому ячейка p95 пуста, а avg/min/max — консольные агрегаты); k6 (xk6-sql) — это НЕ стандартный k6 — кастомный бинарник, собранный с расширением xk6-sql + драйвером postgres (одно подключение на VU, открытое в области init, SELECT 1 на итерацию; метрики сообщаются в формах нативного движка db_query_duration/db_errors). Его базовая версия k6 может отличаться от стандартного k6 — см. сводку окружения CI.
По мелочи
реализована команда perfscale cache clean — очистка кэша скачанных модулей;
self-update стал интерактивным и научился ретраям на медленных сетях (если надо, есть флаг --non-interactive)
dev-сборки маркируются версией 0.25.0-next.N+g — по выводу --version сразу видно, что перед вами не релиз; это помогает с тестированием между релизами.
для CI: строгая проверка checksums, SHA-пины в github-action, gitlab-ci и Helm-чартах; Ранее проверка давала warning, а теперь будет падать
sdk-js проект заархивирован, поскольку он не использовался, а расширения переехали в sdk-libraries и WASM модули.
Perfscale platform
Каталог для pro модулей
Итак, у нас уже скопилось много pro модулей(SOAP, FIX, LLM, PubSub, SQL), и это расширяет выходной бинарник, при этом люди могут и не пользоваться и половиной от того функционала, который мы предлагаем. Поэтому после того, как мы научились запекать модули (эта информация была в новостях #13 ) мы начали думать над тем, как запекать модули точечно, т.е. то, что реально используется в запусках. Например, если используется только pro/sql модуль, то не надо включать другие модули, такие как SOAP, FIX и других. Это не раздувает бинарник, но при этом перекладывает запекание на запуск перед самим запуском сценария. А хорошо это или плохо - покажет время.
Ну а на сегодня все. Желаю, чтобы порты всегда выходят из TIME_WAIT вовремя, а сервисы держат свои пять девяток. До следующего выпуска!
Ссылки
Документация: в репозитории и во вкладке Docs дашборда perfscale serve --ui
Платформа: perfscale.ru и perfscale.su
Релизы и бинарники: GitHub Releases, npm @perfscale/exe



 English (US) ·
 Russian (RU) ·