
 2 часов назад
4
GitHub объявила о переносе 99,99999 % репозиториев в Azure. «За последний год, на фоне экспоненциального роста трафика Git, 99,99999 % репозиториев GitHub стали размещаться одновременно в двух местах: в наших собственных дата-центрах и в Azure. Оставшиеся репозитории — одни из самых активно используемых на платформе, и их переносу мешает лишь один фактор: задержка в 25 мс при обмене данными (round trip)», — сообщила компания.
Компания объяснила сроки и формат перехода «агентным сдвигом» (agentic shift): стремительным ростом трафика, жёсткими ограничениями по энергопотреблению в её дата-центрах и прилегающих регионах, а также физическими трудностями в цепочках поставок. Рост трафика, генерируемого программными агентами, повысил нагрузку на критически важные сервисы (уровень Tier 0), обеспечивающие основные операции с репозиториями.
Источник изображения: GitHub
Учитывая масштаб системы и её критическую важность для сообщества, GitHub тщательно выстроила последовательность действий, решив сначала перенести данные, сервисы и все сопутствующие зависимости, а затем, после их перемещения, развивать архитектуру.
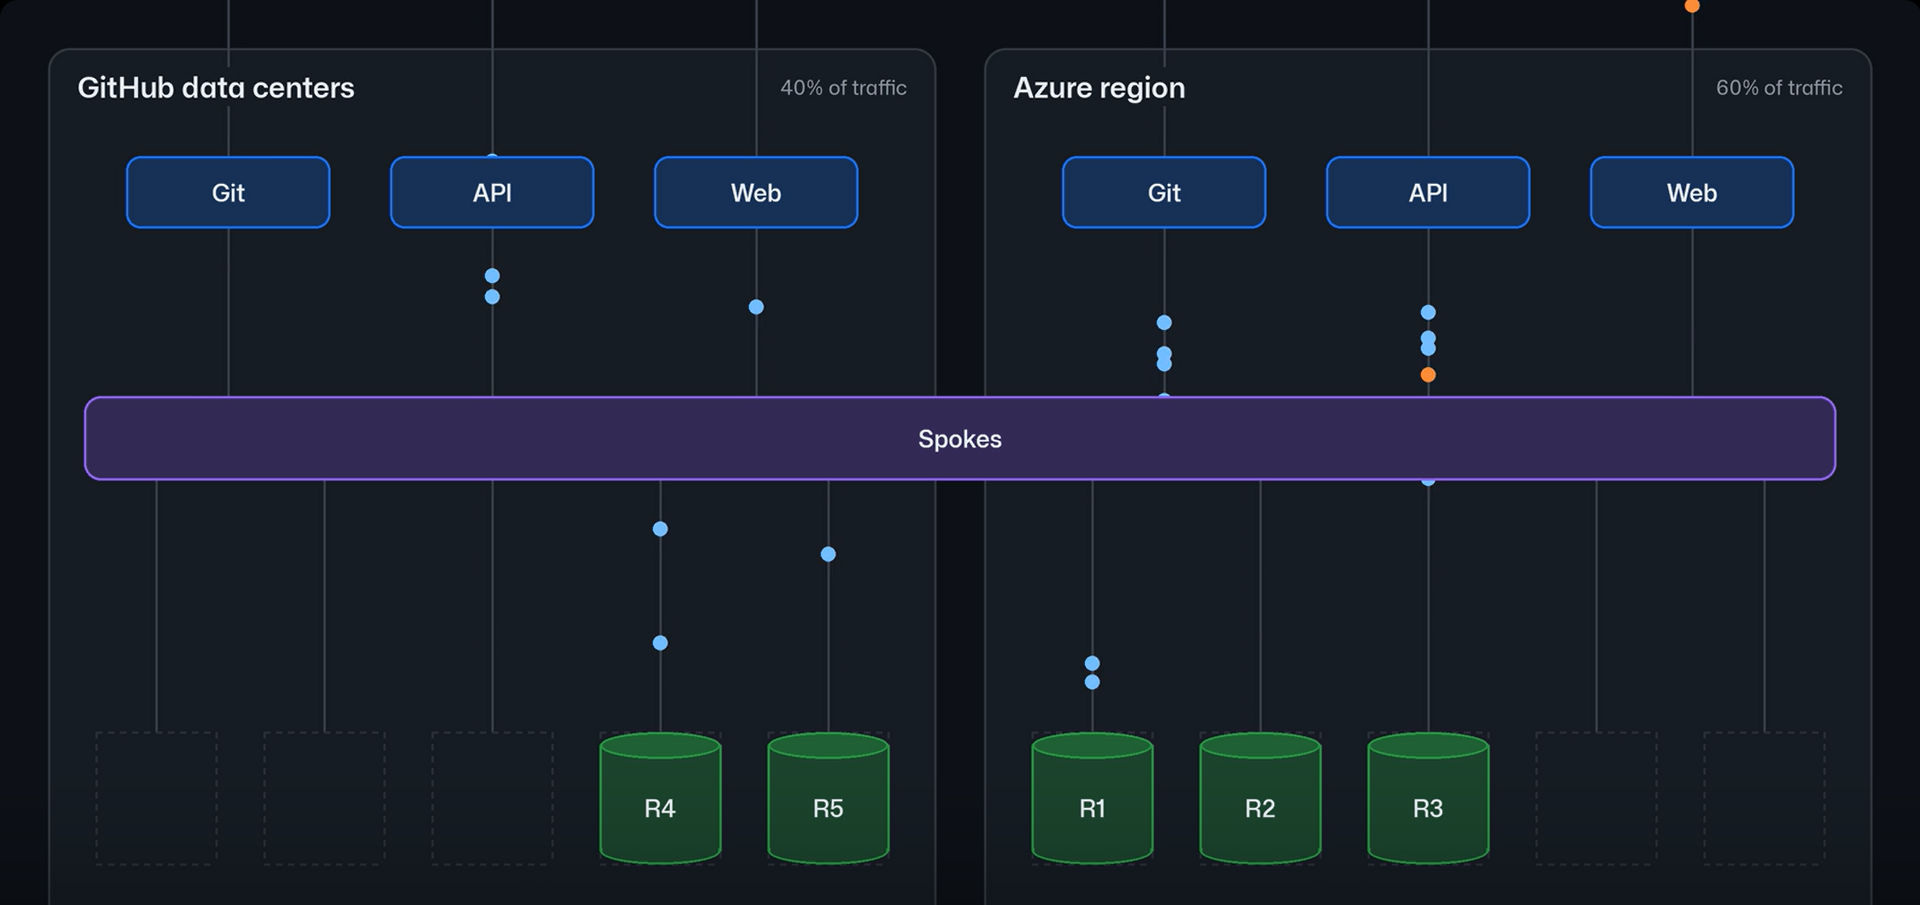
Первая копия репозитория была размещена в регионе Azure Central US в августе 2025 года. На данный момент у большинства репозиториев две из пяти реплик находятся в Azure, и на долю этой платформы приходится около половины всего трафика Git. На протяжении большей части этого периода Azure брала на себя растущую нагрузку, в то время как собственные дата-центры GitHub сохраняли стабильные показатели. При этом GitHub опиралась на два принципа: минимизацию координации и отделение хранилища от вычислительных ресурсов. В GitHub описывают эту работу как «мост» между текущей архитектурой (системой Spokes) и следующей моделью хранения данных.
Для большинства репозиториев GitHub создаёт пять реплик, распределнных по разным регионам и зонам доступности. Сервис Spokes использует механизм предпочтительной маршрутизации, направляя каждый запрос к реплике, находящейся в том же регионе и зоне доступности, что и источник запроса. По мере переноса реплик в Azure доля трафика, обслуживаемого этой платформой, увеличивается — до тех пор, пока не будет перемещена последняя реплика, после чего старый регион полностью перестает получать запросы.
В текущей архитектуре репозиторий, размещённый более чем в одном регионе, имеет более низкий предел пропускной способности для операций записи. Для их подтверждения системе Spokes требуется большинство реплик, при этом кворум ожидает ответа от каждой исправной реплики вплоть до истечения времени ожидания (тайм-аута). Задержка при записи определяется самой медленной из исправных реплик. Поскольку на время выполнения записи накладывается блокировка всего репозитория, эта задержка также ограничивает максимальную пропускную способность репозитория.
Если одна из реплик оказывается в целевом регионе Azure — на расстоянии около 1600 км от дата-центров GitHub, — каждый цикл обмена данными по сети (round trip) занимает примерно 25 мс, а для выполнения записи требуется несколько таких циклов. Если репозиторий уже работает на пределе своей пропускной способности, он не сможет «поглотить» эти дополнительные временные затраты при каждой записи, в результате чего очередь операций push начнёт расти.
Здесь вступает в силу принцип минимизации координации. В данном случае это означает: не стоит сериализовать (выполнять строго последовательно) те операции, которые в этом не нуждаются. В связи с этим меняется область действия кворума: теперь он распространяется не на весь репозиторий целиком, а на отдельные ссылки.
Запись с привязкой к конкретной ссылке (ref) сохраняет порядок операций, требуемый Git. Git предполагает наличие опредёленной последовательности событий для каждой ссылки (ветки или тега): как только сервер принимает новое значение, клиент видит либо это значение, либо более позднее. Между независимыми ссылками требования к согласованности отсутствуют.
При сериализации на уровне отдельных ссылок (per-reference serialization) ожидание репозитория, то есть его временная блокировка, требуется только в тех случаях, когда операции записи затрагивают одну и ту же общую ссылку. На практике большинство операций записи в репозиторий направлено на разные ссылки. Когда агенты и разработчики работают с разными ветками, их операции больше не блокируют друг друга. Хотя каждая операция записи по-прежнему подвержена задержкам, связанным с передачей данных между регионами, операции с разными ссылками могут выполняться параллельно. Такой подход устраняет необходимость в единой очереди для всего репозитория, сохраняя при этом гарантии согласованности, на которые полагаются клиенты Git.
По данным внутреннего тестирования было зафиксировано, что при записи в разные ссылки пропускная способность возрастает в 3–4 раза, а задержки при этом снижаются.
В большинстве репозиториев соотношение операций чтения к записи составляет от 100:1 до 1000:1. В текущей архитектуре реплик GitHub чтение и запись выполняются на одних и тех же вычислительных ресурсах, из-за чего они конкурируют за память и процессорное время, что исключает возможность их независимого масштабирования.
Новая архитектура предусматривает разделение мощностей для чтения и записи, благодаря чему для каждой задачи можно задать собственную конфигурацию.
На первом этапе объектное хранилище включается в состав кворума в качестве «виртуальной реплики записи» (virtual write replica) — временного узла, который передаёт входящие данные записи в Azure Blob Storage, но не обслуживает запросы на чтение. Spokes включает этот узел в кворум и отправляет подтверждение записи клиенту после того, как данные будут надёжно сохранены в объектном хранилище.
Виртуальная реплика записи также объединяет транзакции, затрагивающие независимые ссылки, в единый пакет сетевых операций ввода-вывода при обращении к объектному хранилищу. Благодаря этому для активно используемого репозитория вместо отдельного сетевого запроса на каждую операцию записи выполняется лишь один запрос для целого ряда одновременных операций. На текущем этапе виртуальная реплика записи также отвечает за процесс уплотнения данных (compaction), а реплики чтения (read replicas) получают уже уплотнённое состояние.
Использование виртуальных реплик записи позволяет по мере необходимости масштабировать систему, создавая любое количество виртуальных реплик чтения. Каждая такая реплика наполняет свой кеш данными из Azure Blob Storage и начинает обслуживать запросы на чтение, не становясь участником кворума. Единственным достоверным источником данных выступает объектное хранилище, с которым реплика в фоновом режиме согласовывает своё локальное состояние.
Поскольку синхронизация проходит в фоновом режиме, реплики подходят не для всех типов рабочих нагрузок, связанных с чтением. Для поддержки любых видов операций чтения процесс синхронизации должен быть переведён в синхронный режим (in-line): реплика должна запрашивать только те данные и состояния, которые изменились с момента её последней синхронизации.
Компания отметила, что, несмотря на эти изменения, кворум по-прежнему остаётся ограничивающим фактором для дальнейшего роста.
GitHub утверждает, что Spokes обрабатывает более 100 млрд операций в день, и предупреждает, что его протокол фиксации изменений (commit protocol) не сможет обеспечить работу сервиса с миллиарда репозиториев до следующего миллиарда. Сегодня Spokes представляет собой интеллектуальный уровень маршрутизации и балансировки нагрузки, единый API, через который внутренние сервисы получают доступ к данным репозиториев, а также набор фоновых процессов — так называемых «чистильщиков» (sweepers), — которые управляют размещением репозиториев, их восстановлением и перераспределением между узлами хранения.
Компания отметила, что после реализации этих шагов следующим ограничивающим фактором станет пропускная способность операций записи. Каждая операция записи по-прежнему зависит от реплик, каждая из которых хранит полную копию репозитория, хотя лишь малая часть данных, записываемых в репозиторий, требует строгого упорядочивания. Объекты Git неизменяемы и идентифицируются по своему содержимому, поэтому их можно сохранять без необходимости достижения консенсуса между узлами. Остаётся лишь небольшой объём данных, и самая сложная задача — упорядочить их максимально быстро, не создавая при этом «узкого места» в другом звене системы.
Как ожидается, подробности о финальной версии архитектуры платформы компания сообщит на GitHub Universe.
Если вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER. | Можете написать лучше? Мы всегда рады новым авторам.
Источник:





 English (US) ·
 Russian (RU) ·