
 1 час назад
3
Китайская лаборатория искусственного интеллекта Moonshot AI представила Kimi K3.1 Pro — обновлённую версию модели Kimi K3, которая прошла дополнительное обучение с использованием большего объёма вычислительных ресурсов. В рейтинге Artificial Analysis Intelligence Index она набрала 55 баллов, обойдя предшественницу на 11 баллов, опередив все модели OpanAI и заняв четвёртую строчку.
Источник изображений: kimi.com
Выше Kimi K3.1 Pro в рейтинге оказались Anthropic Claude Opus 5.5 (58 баллов), Claude Sonnet 5.5 (56 баллов) и Meta✴ Muse Wonder Full (56 баллов). Moonshot AI намерена открыть веса модели 4 ноября, и она станет самой мощной в классе открытых систем. Разрыв между открытыми и проприетарными моделями сократится с 12 до 3 баллов, если к тому времени ситуация на рынке не изменится. Разработчик также выпустил версию Kimi K3.1 Pro Highspeed — она работает в два-три раза быстрее. Обе модели уже доступны на платформах Kimi.ai, Kimi Work, Kimi Code и через API.
Наиболее заметный прогресс Kimi K3.1 Pro показала в агентных задачах: в бенчмарке GDPval-AA она набрала 1846 баллов по Эло, опередив K3 на 312 баллов. Здесь она уступила лишь Claude Opus 5.5 (1866 баллов) и Wonder Full (1857 баллов). В Terminal-Bench 4.0 продемонстрировала 65,7 %, обогнав OpenAI GPT-6 Astra (58,2%) и лишь немного уступив Claude Opus 5.5 (66,4%) — K3 в том же тесте набрала всего 13 %.
В рамках внутреннего теста Kimi Hallu Bench Hard доля галлюцинаций, то есть заведомо не соответствующих действительности ответов, снизилась с 23,4 % у K3 до 8,3 % у новой модели. Это стресс-тест, а не показатель общего уровня ошибок, подчеркнули в Moonshot; для сравнения, GPT-6 Astra в том же тесте показала 5,5 %, то есть сохранила преимущество. В финансовых тестах Kimi K3.1 Pro показала прирост на 7,2 балла по направлению финансового моделирования и на 11,6 балла — по финансовым исследованиям. В связанном с офисными задачами бенчмарке OfficeQA Pro v2 модель обошла вообще всех конкурентов, утверждает Moonshot.
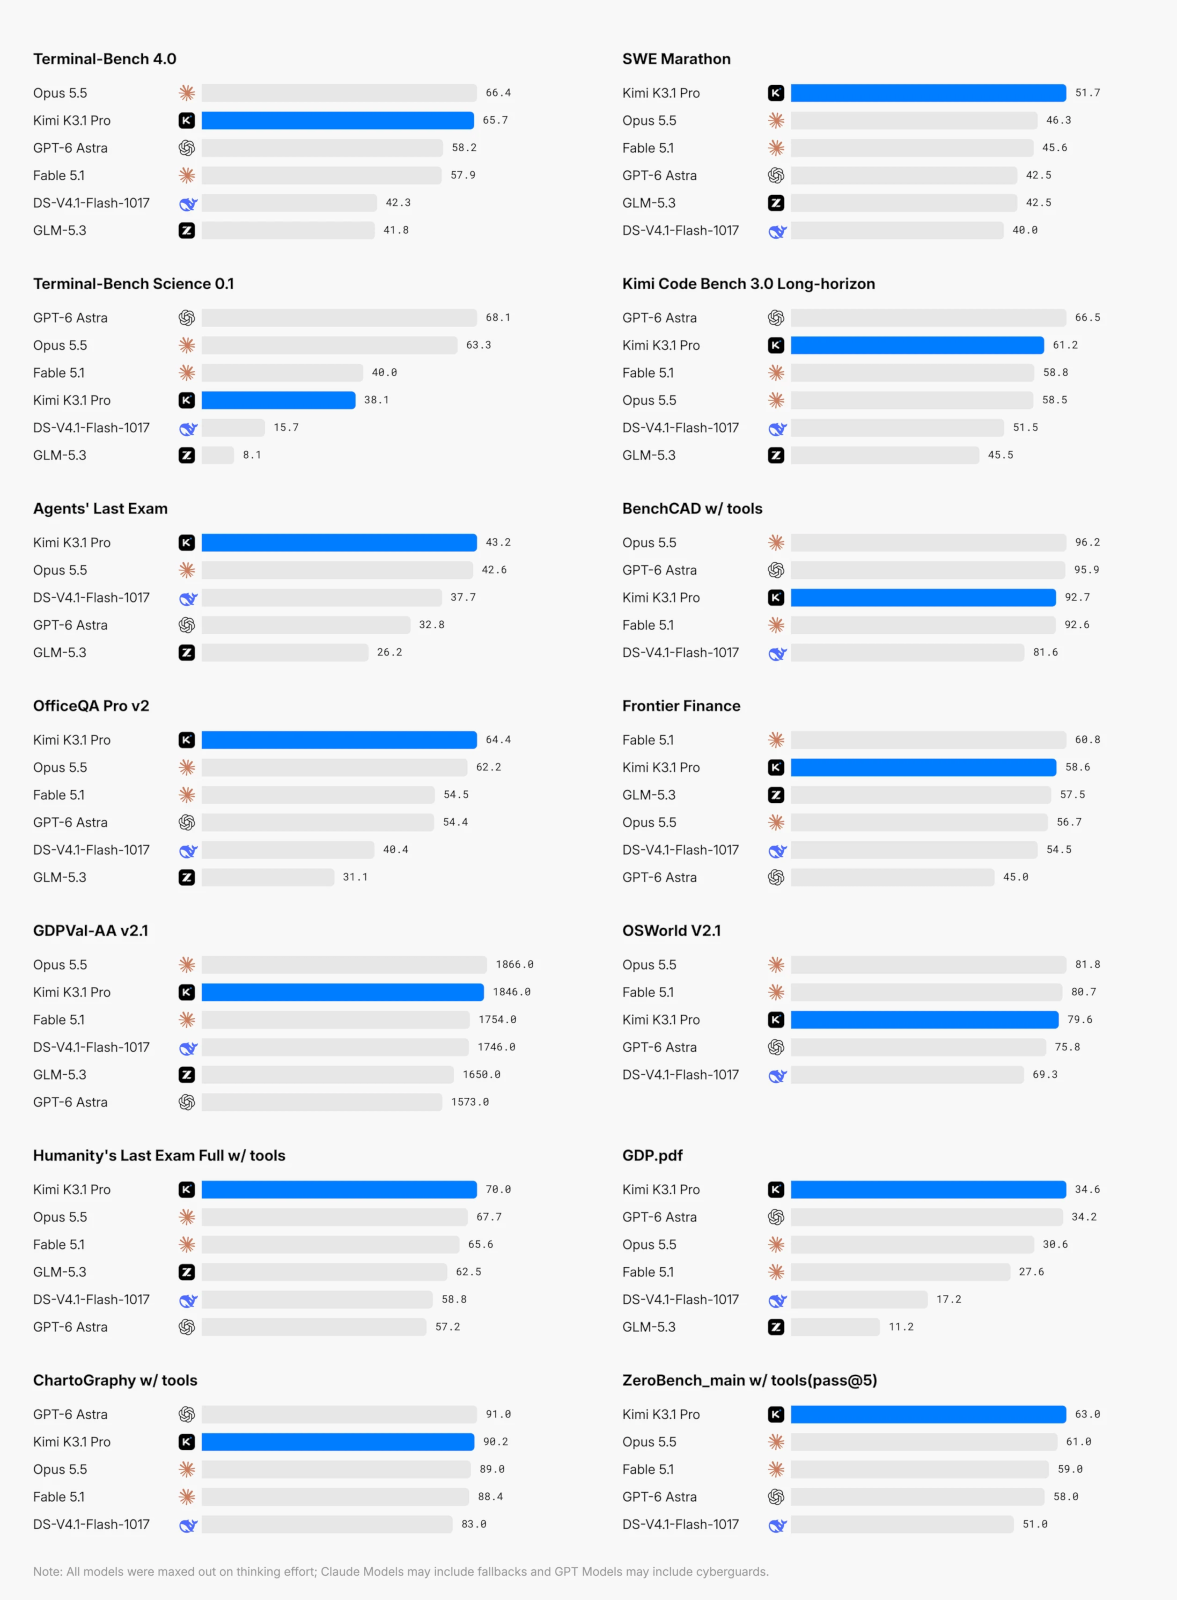
Kimi K3.1 Pro поддерживает прямое взаимодействие с игровыми движками, в том числе Unity, Unreal Engine и Godot — она может вносить оперативные исправления и производить сборку проектов. При использовании вспомогательных инструментов в тесте BenchCAD она набрала 92,7 %, выступив близко к показателям Claude Opus 5.5 (96,2%) и GPT-6 Astra (95,9%). Без использования инструментов результат снизился до 72,8 %, и это почти равно показателю Claude Opus 5.5 (73,0 %). Лучше всего модель справляется с параметрическим моделированием механических деталей, архитектурных объектов и объектов с настраиваемыми параметрами. Она умеет создавать и запускать скрипты для Blender и CAD-систем без MCP-коннекторов. На платформе Kimi.com появилась функция 3D Make — она позволяет просматривать, редактировать и экспортировать трёхмерные модели.
Модель Kimi K3.1 Pro унаследовала размер предшественницы — 2,8 трлн параметров, из которых активны 104 млрд. Контекстное окно имеет размер в 1 млн токенов, поддерживается работа с текстом и изображениями. По данным Artificial Analysis, она находится на вершине «границы Парето»; у неё самый высокий показатель Intelligence Index среди моделей сопоставимого размера.
Стоимость эксплуатации снизилась на 33 %: $2 за 1 млн входных токенов (было $3), $10 за 1 млн выходных токенов (было $15) и $0,20 за работу с кешированными данными (было $0,30). Выполнение одной задачи из набора Intelligence Index обходится в $1,98 — почти столько же, сколько для K3 ($2,00) – при том, что новая модель генерирует на 14 % больше выходных токенов.
По мере масштабирования этапа пост-обучения у модели усиливались способности к поиску уязвимостей, отметили в Moonshot: связанные с кибербезопасностью материалы присутствовали в общем массиве данных, соответствующие задачи были включены в среду обучения с подкреплением. При подготовке версии с открытыми весами разработчик удалил касающиеся кибербезопасности данные на обоих этапах обучения. В ходе внутреннего тестирования с бенчмарком xdev-bench-hard, включающем выявленные за последнее время уязвимости в ядре Linux, Node.js и JavaScriptCore, исходный вариант модели успешно справился с 90,5 % задач; после удаления данных этот показатель снизился до 81,0 %. Для сравнения, в том же тесте DeepSeek-V4.1-Flash показала 85,7 %, а Kimi K3 — 33,3 %.
Модели с открытыми весами не должны расширять границы возможностей в сфере наступательной кибербезопасности, считают в Moonshot. В то же время лаборатория стремится постепенно повышать функциональные возможности открытых моделей, потому что они могут оказаться полезными и в защите — например, при анализе устаревших систем. Ранее Anthropic продемонстрировала, что китайская модель Z.ai GLM-5.3 с 45 баллами в AA Index способна создавать эксплойты, по уровню сложности сопоставимые с теми, что генерирует Claude Mythos.




 English (US) ·
 Russian (RU) ·