
 1 час назад
3
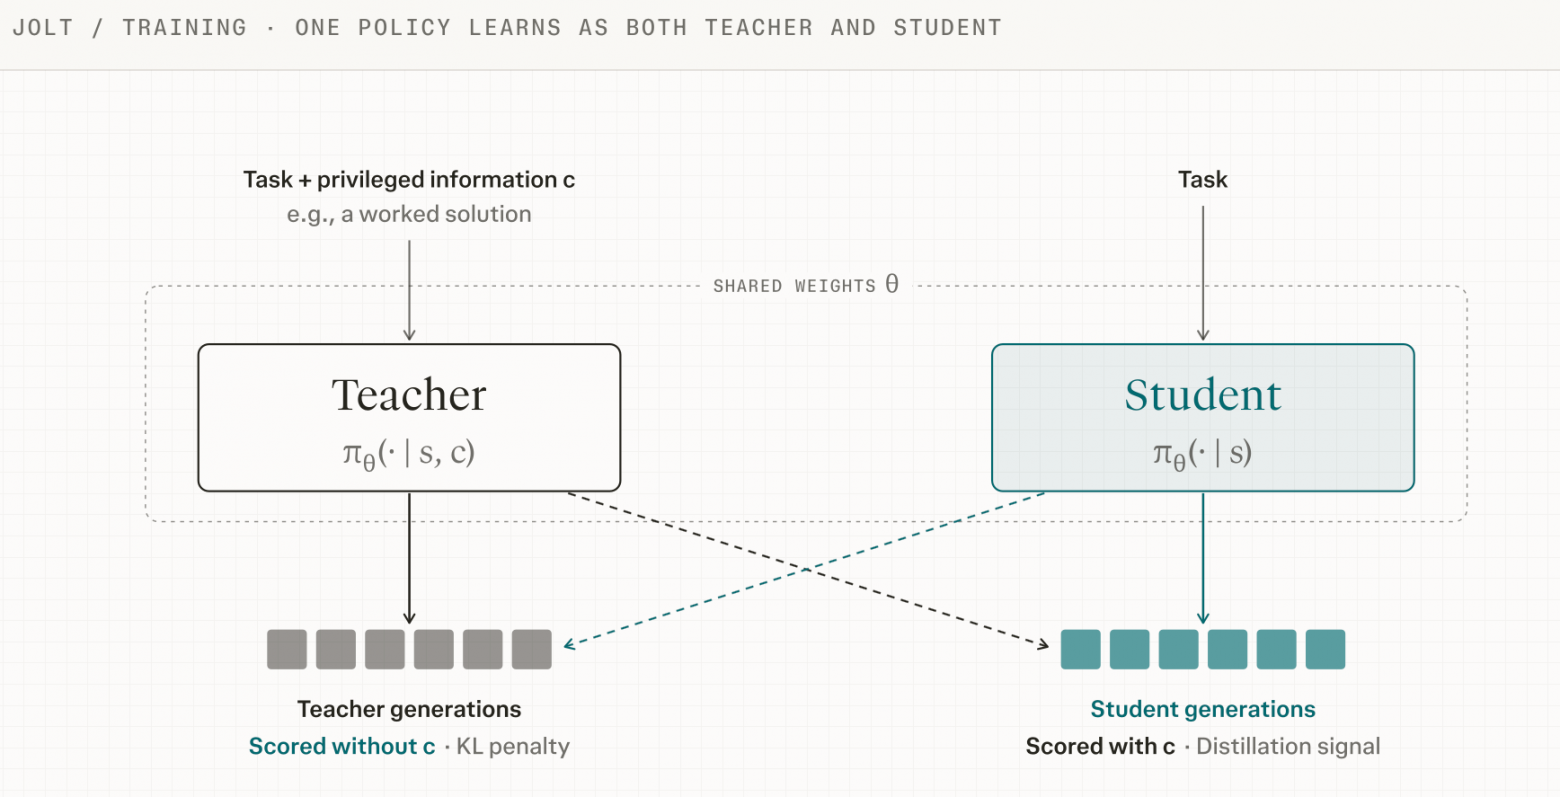
21 октября Perplexity Research вместе с NVIDIA представила метод JOLT (Joint On-policy Learning and Teaching) для пост-обучения языковых моделей. Одна и та же модель играет две роли. Учитель видит привилегированную информацию вроде проверенного решения, ученик ее не видит, и обе роли обучаются совместно. Давайте разбирать, превзошел ли ученик учителя.
Какую проблему решают
Сегодня стандарт дообучения рассуждающих моделей — обучение с подкреплением по итоговой награде, чаще всего Group Relative Policy Optimization (GRPO). Сигнал у такого обучения редкий. Модель узнает только, решила она задачу или нет, и на длинных агентных сценариях это превращается в огромный расход вычислений.
Альтернатива — on-policy дистилляция, где более сильный учитель оценивает каждый токен ученика. Сигнал плотнее, но, во-первых, нужен отдельный учитель. Во-вторых, тот, кто хорошо решает, не обязательно хорошо объясняет.
Самодистилляция (OPSD) избавляет от потребности в отдельном учителе. Та же модель, получив доступ к ответу, оценивает собственные попытки. Но учитель, который знает решение, может давать подсказки, совершенно непосильные для ученика без этого знания, и тогда самодистилляция ухудшает результат. В экспериментах на Terminal-Bench OPSD действительно оказалась ниже исходной модели при любом числе попыток.
Как устроен метод
Авторы выводят условие, при котором обновление от учителя совпадает с градиентом ожидаемой награды ученика, и превращают его в цель обучения для учителя. Учитель тренируется на собственных попытках с KL-регуляризацией к ученику, то есть ему не дают уйти слишком далеко от того, что ученик в принципе способен сделать. Ученик обучается обычной обратной KL-дистилляцией по токенным оценкам учителя. Вариант JOLT+ добавляет к этому центрированную итоговую награду самого ученика.
Что показали эксперименты
Проверяли на пяти наборах и пяти разных базовых моделях, от Qwen3-0.6B до Qwen3-30B-A3B. По данным авторов, JOLT+ обходит GRPO на GSM8K на 1,5 п. п., на MATH — на 4,2, на LiveCodeBench v6 — на 3,0, а на агентном AppWorld — сразу на 9,9 п. п. На Terminal-Bench 2.1 JOLT+ лидирует при любом числе попыток, от 10,96% при pass@1 до 34,83% при pass@32.
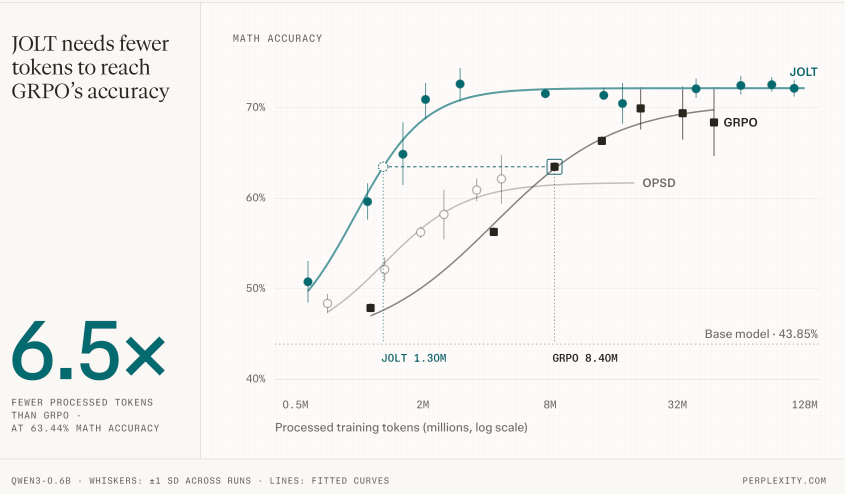
Самая практичная цифра касается эффективности. На бенчмарке MATH для выхода на точность 63,4% алгоритму GRPO потребовалось 8,4 млн обработанных токенов, в то время как JOLT (по аппроксимированной кривой) уложился всего в 1,3 млн — то есть примерно в 6,5 раза меньше. Если же брать в расчет только сгенерированные токены, то разрыв увеличивается до 13 раз. Впрочем, чистый JOLT без награды ученика уступает GRPO на AppWorld и Terminal-Bench, поэтому наилучший результат дает именно их комбинация.
Почему это стоит внимания
Пост-обучение стало большой статьей расходов на вычисления у тех, кто дообучает открытые модели под свои задачи. Тут кратное сокращение токенов на одну и ту же точность прямо переводится в деньги и время. Участие NVIDIA делает вероятным, что метод быстро появится в ее стеке для дообучения. Хотя прямо об этом компании не заявляли. Еще подчеркну, что JOLT лучше всего работает на агентных задачах, где у разработчиков как раз есть привилегированная информация: логи успешных попыток, результаты тестов, сообщения верификатора.
Еще важно помнить, что все эксперименты пока проведены на сравнительно небольших моделях, независимых воспроизведений нет, и выигрыш на одних бенчмарках заметно больше, чем на других.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.





 English (US) ·
 Russian (RU) ·